Một hai năm gần đây, thuật ngữ “ngăn ngừa mất dữ liệu” (DLP) bị các nhà cung cấp giải pháp bảo mật lạm dụng để khiến sản phẩm của họ nghe như có ích trong việc giải quyết vấn nạn rò rỉ dữ liệu. Điều này khiến khó phân biệt công nghệ nào xứng đáng được gọi là “DLP” và công nghệ nào không. Để làm rõ, hãy cùng xem công nghệ DLP là gì, hoạt động ra sao, làm được gì và không làm được gì.
Thuật ngữ “ngăn ngừa mất dữ liệu” mô tả công nghệ tự động nhận diện và bảo vệ dữ liệu nhạy cảm. Một hệ thống DLP có các thành phần thực hiện ba chức năng: Quản lý (Management), Nhận diện (Identification) và Bảo vệ (Protection). Thành phần Quản lý là nơi quản trị viên tạo và quản lý các chính sách mà hệ thống DLP thực thi, đồng thời tạo các báo cáo cần thiết. Thành phần Nhận diện tìm dữ liệu nhạy cảm theo định nghĩa trong chính sách. Thành phần Bảo vệ bảo vệ dữ liệu nhạy cảm mà thành phần Nhận diện tìm thấy. Hình 1 cho thấy mối quan hệ giữa ba thành phần này. Mỗi thành phần có những thách thức riêng, và chúng ta sẽ lần lượt xem xét từng thành phần.
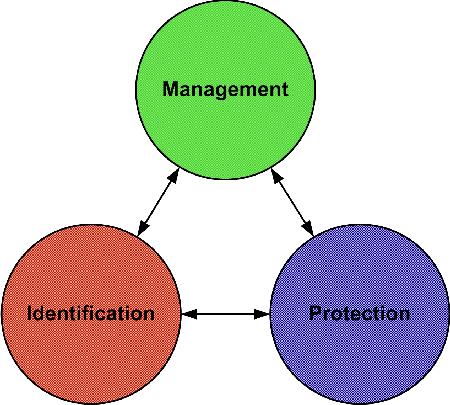
Hình 1. Các thành phần chức năng của hệ thống DLP.
Tự động hóa việc bảo vệ dữ liệu nhạy cảm rất quan trọng vì ngay cả người có ý tốt nhất cũng mắc sai lầm. Báo cáo Trends in Information Security năm 2008 của CompTIA ước tính 30% các vụ rò rỉ dữ liệu nghiêm trọng do lỗi của con người, 30% khác do tin tặc lợi dụng lỗi của con người, và chỉ 40% do tin tặc chủ động vượt qua lỗ hổng công nghệ. Những con số này khác khá nhiều so với năm năm trước. Báo cáo cùng tên năm 2003 ước tính chỉ 8% các vụ rò rỉ nghiêm trọng không liên quan đến lỗi của con người.
Con người đang bảo vệ dữ liệu nhạy cảm tốt hơn, nhưng vẫn chưa thật sự giỏi. Phần lớn các vụ rò rỉ nghiêm trọng vẫn do con người chứ không phải do công nghệ. Vì vậy, tự động hóa quy trình bảo vệ dữ liệu sẽ cho kết quả tốt hơn nhiều so với chỉ dựa vào con người vốn dễ mắc lỗi, và đó chính là nơi công nghệ DLP hứa hẹn tạo ra khác biệt.
Quản lý
Chính sách của hệ thống DLP xác định loại dữ liệu nào được coi là nhạy cảm, thao tác nào được phép với dữ liệu nhạy cảm và cách bảo vệ dữ liệu đó. Giả sử ta muốn ngăn số an sinh xã hội (Social Security number) chưa mã hóa bị gửi đến địa chỉ email bên ngoài. Mục tiêu tưởng chừng đơn giản này thực ra có thể khó triển khai toàn diện, nghĩa là khó xây dựng một chính sách mô tả chính xác mục tiêu đó. Hãy xem các ví dụ trong Bảng 1. Mỗi trường hợp có thể chứa hoặc không chứa số an sinh xã hội. Chẳng hạn, số 123456789 có thể là số an sinh xã hội, hoặc là số điện thoại của ai đó ngoài nước Mỹ. Một chính sách nhằm ngăn số an sinh xã hội chưa mã hóa bị gửi ra ngoài cần xác định được trường hợp nào sẽ được thành phần Nhận diện của hệ thống DLP coi là chứa số an sinh xã hội, và trường hợp nào không.
| Tình huống |
| Email chứa “123-45-6789” |
| Email chứa “123456789” |
| Email có tệp bảng tính đính kèm chứa “123456789” |
| Email chứa “123-456-789” |
| Email chứa URL “http://www.binhminhitc.com/books/123456789/” |
| Email chứa mã nguồn thực hiện lệnh print(123456789) |
| Email có tệp chương trình thực thi đính kèm thực hiện lệnh print(123456789) |
Bảng 1. Các ví dụ có thể chứa hoặc không chứa số an sinh xã hội.
Chính sách của hệ thống DLP cũng quy định thành phần Bảo vệ cần làm gì khi thành phần Nhận diện tìm thấy dữ liệu nhạy cảm. Khi phát hiện số an sinh xã hội chưa mã hóa, thành phần Bảo vệ có thể mã hóa thư và gửi bản đã mã hóa cho người nhận. Hoặc nó có thể thông báo cho người gửi rằng họ đã vi phạm chính sách bảo vệ dữ liệu và cần mã hóa thư thì mới gửi được.
Khả năng của thành phần Quản lý bị giới hạn bởi mức độ toàn diện của nó, tức là nó có thể định nghĩa quy tắc cho bao nhiêu định dạng dữ liệu. Chẳng hạn, mỗi định dạng tệp mã hóa thông tin theo cách khác nhau. Hệ thống DLP cần hiểu định dạng dữ liệu để tìm thông tin nhạy cảm trong đó. Ví dụ, số an sinh xã hội trong tệp văn bản nén sẽ được mã hóa khác với cùng số đó trong bảng tính. Nói chung, hệ thống DLP hiểu càng nhiều định dạng dữ liệu thì càng toàn diện, và thường có khả năng tìm và bảo vệ thông tin nhạy cảm tốt hơn.
Tuy nhiên, hãy cẩn trọng với tuyên bố của nhà cung cấp. Việc công nghệ DLP của một hãng nhận diện được nhiều loại định dạng tệp chưa đủ để nó tìm ra thông tin nhạy cảm trong tất cả các loại tệp đó. Điều quan trọng là công nghệ tìm dữ liệu nhạy cảm kỹ đến mức nào. Muốn vậy, nó cần hiểu nội dung của nhiều loại tệp cũng như nhiều giao thức mạng. Đó là thước đo phù hợp hơn cho mức độ toàn diện của hệ thống DLP so với số loại tệp nó chỉ đơn thuần nhận diện được.
Khả năng của các công cụ mà quản trị viên dùng để định nghĩa chính sách cho thành phần Nhận diện cũng quan trọng. Để được coi là công nghệ DLP, các quy tắc này phải làm được nhiều hơn việc tìm từ khóa. Các công nghệ DLP tiên tiến dùng kỹ thuật nâng cao như biểu thức chính quy (regular expression) và so khớp mẫu thống kê để nhận diện thông tin nhạy cảm. Để tìm dữ liệu nhạy cảm kỹ hơn, cần định nghĩa được những chính sách chi tiết và phức tạp hơn, vì vậy thành phần Quản lý tinh vi là phần không thể thiếu của công nghệ DLP tiên tiến.
Nhận diện
Thành phần Nhận diện của hệ thống DLP dùng chính sách do thành phần Quản lý định nghĩa để tìm thông tin nhạy cảm. Trừ những trường hợp đơn giản nhất, điều này có nghĩa thành phần Nhận diện sẽ thực hiện một phép kiểm định thống kê và dựa vào kết quả để quyết định có tìm thấy thông tin nhạy cảm hay không. Vì dùng kiểm định thống kê, thành phần Nhận diện không bao giờ quyết định đúng trong mọi trường hợp.
Mọi phép kiểm định thống kê đều có khả năng dương tính giả (false positive) và âm tính giả (false negative). Dương tính giả xảy ra khi dữ liệu không nhạy cảm bị nhận nhầm là nhạy cảm. Khi đó không có dữ liệu nhạy cảm nào bị lộ, nhưng phải trả giá bằng thời gian và công sức lãng phí của con người, nhất là khi họ phải tìm cách xoay xở với kết quả sai. Âm tính giả xảy ra khi dữ liệu nhạy cảm bị nhận nhầm là không nhạy cảm. Khi đó, dữ liệu nhạy cảm không được bảo vệ, có thể dẫn đến mất mát hoặc bị lộ.
Đặc điểm của mọi phép kiểm định thống kê là với một công nghệ cụ thể, không thể đồng thời giảm cả dương tính giả lẫn âm tính giả. Nghĩa là nếu điều chỉnh tham số của thành phần Nhận diện để giảm tỷ lệ dương tính giả thì tỷ lệ âm tính giả sẽ tăng, và ngược lại. Đây là giới hạn do bản chất của kiểm định thống kê chứ không riêng gì công nghệ DLP; các công nghệ bảo mật khác dùng kiểm định thống kê cũng có giới hạn tương tự.
Công nghệ nổi tiếng nhất trong số đó có lẽ là phát hiện xâm nhập (intrusion detection), cũng phải đánh đổi giữa dương tính giả và âm tính giả. Vì vậy, nếu bạn là người quản lý bảo mật đang muốn hiểu hiệu quả có thể có của một hệ thống DLP, quản trị viên hệ thống phát hiện xâm nhập của bạn có lẽ là nguồn thông tin tốt về tác động của dương tính giả và âm tính giả đến cả hiệu năng hệ thống lẫn bảo mật.
Bảo vệ
Khi thành phần Nhận diện của hệ thống DLP xác định đã tìm thấy dữ liệu nhạy cảm, thành phần Bảo vệ sẽ thực hiện hành động theo yêu cầu của chính sách. Chặn và mã hóa là hai hành động phổ biến nhất.
Ví dụ, nếu người dùng đang sao chép dữ liệu nhạy cảm sang ổ USB, thành phần Bảo vệ của hệ thống DLP có thể chặn việc sao chép đó. Trong trường hợp khác, thành phần Bảo vệ có thể mã hóa dữ liệu nhạy cảm sao cho chỉ người dùng được phép mới giải mã được. Nếu người dùng đang lưu một tệp chứa dữ liệu nhạy cảm, thành phần Bảo vệ có thể mã hóa tệp trước khi lưu.
Chặn thao tác của người dùng thường không gây vấn đề kỹ thuật đáng kể, dù có thể làm tăng số cuộc gọi đến bộ phận hỗ trợ (help desk). Phần lớn người dùng bị hệ thống DLP chặn không có ý đồ xấu; họ chỉ đang cố làm việc của mình. Họ thường cần được hướng dẫn cách làm việc trong các giới hạn mà hệ thống DLP đặt ra, và điều này làm tăng số yêu cầu hỗ trợ.
Ngược lại, dùng mã hóa để bảo vệ dữ liệu nhạy cảm có thể gây vấn đề kỹ thuật đáng kể, cả do khó khăn trong quản lý khóa lẫn do nhiều hệ thống gặp khó khi xử lý dữ liệu đã mã hóa.
Khóa mật mã giống như mã số của két sắt. Có mã số thì mở két dễ dàng, không có thì rất khó. Tương tự, có đúng khóa thì giải mã dữ liệu dễ dàng, không có khóa thì gần như không thể. Nhưng nếu bạn bất cẩn với mã số két sắt, người khác có thể dễ dàng tìm ra, và khi đó két sắt không còn bảo vệ được gì. Tương tự, khóa mật mã dùng để mã hóa dữ liệu cần được xử lý cẩn thận. Nếu bất cẩn, sự bảo vệ của mật mã gần như bị vô hiệu. Quản lý khóa bao gồm mọi chi tiết về cách xử lý khóa đủ cẩn thận để điều đó không xảy ra. Nó bảo đảm bạn không làm điều tương đương với việc ghi mã số két sắt lên giấy nhớ rồi dán lên tường cạnh bàn làm việc.
Một vấn đề rõ ràng liên quan đến quản lý khóa mà công nghệ DLP có thể gây ra là khôi phục dữ liệu. Nếu vì lý do nào đó không có khóa để giải mã, thì việc bảo vệ dữ liệu bằng mã hóa chẳng khác gì “hủy” dữ liệu bằng mật mã. Để tránh điều này, mọi khóa mật mã mà hệ thống DLP dùng phải luôn sẵn sàng. Việc này có thể tốn kém và dễ trở thành khoản chi lớn mà người dùng DLP không lường trước và lên kế hoạch.
Công nghệ quản lý khóa hiện nay cũng chưa đến mức có thể dễ dàng yêu cầu và tải khóa qua Internet. Nghĩa là nếu hệ thống DLP tìm thấy và mã hóa dữ liệu nhạy cảm, có thể khó hoặc không thể giải mã dữ liệu đó khi nó được chuyển ra ngoài mạng nơi nó được mã hóa ban đầu. Ví dụ, nếu dữ liệu được lưu trên băng sao lưu và chuyển đến một cơ sở bên ngoài để lưu trữ, có thể không giải mã được ở đó vì không lấy được khóa cần thiết.
Giải mã được dữ liệu khi cần cũng quan trọng như bảo vệ được nó. Vì vậy, nếu định dùng công nghệ DLP để mã hóa dữ liệu, bạn nên cân nhắc kỹ cách giải mã dữ liệu khi cần trong tương lai, và bảo đảm công nghệ quản lý khóa của giải pháp DLP đáp ứng được cách bạn cần sử dụng.
Một vấn đề tiềm ẩn khác do công nghệ DLP gây ra là một số hệ thống hiện có không xử lý được dữ liệu đã mã hóa. Mã hóa thường thay đổi cả độ dài lẫn định dạng dữ liệu. Nếu bạn mã hóa số an sinh xã hội gồm chín chữ số, giá trị mã hóa sẽ không còn chỉ gồm chữ số và dài hơn chín ký tự. Trong nhiều môi trường máy tính, có ít nhất một hệ thống không xử lý được dữ liệu mã hóa, và thường không có cách nào biết hệ thống nào gặp vấn đề ngoài việc kiểm thử rộng rãi.
Một giải pháp khả thi là dùng các thuật toán mã hóa bảo toàn định dạng (format-preserving encryption) mới hơn. Thực ra chúng không phải thuật toán mã hóa mới, mà là cách mới để dùng một thuật toán có sẵn, thừa hưởng toàn bộ độ an toàn của thuật toán gốc. Chế độ Feistel Finite Set Encryption Mode (FFSEM) mà NIST đã chấp nhận xem xét làm một chế độ được phê duyệt của AES là ví dụ cho công nghệ này. FFSEM dùng thuật toán mã hóa AES có sẵn theo cách vừa giữ nguyên định dạng của dữ liệu chưa mã hóa vừa giữ toàn bộ sức mạnh của AES; dùng nó để mã hóa dữ liệu nhạy cảm vừa bảo vệ được dữ liệu vừa giúp tương thích với các hệ thống hiện có.
DLP mạng và DLP thiết bị đầu cuối
Có hai nơi có thể dùng công nghệ DLP để bảo vệ dữ liệu: trong mạng hoặc tại thiết bị đầu cuối (endpoint). Nếu hoạt động trong mạng, công nghệ vận hành như Hình 2, nhận diện và bảo vệ dữ liệu nhạy cảm khi dữ liệu di chuyển qua mạng. Đây là cách phổ biến nhất để doanh nghiệp bắt đầu triển khai DLP, thường trước tiên dùng để ngăn mất dữ liệu qua email hoặc Webmail, rồi mở rộng sang các ứng dụng khác.
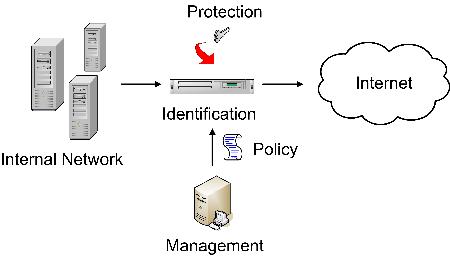
Hình 2. DLP dựa trên mạng.
Một lựa chọn khác ngoài DLP dựa trên mạng là DLP dựa trên thiết bị đầu cuối. Nó hoạt động trên máy chủ hoặc máy trạm và thực thi chính sách của hệ thống DLP ngay tại đó, như Hình 3. Cách này đòi hỏi mở rộng hệ thống DLP tới mọi máy trạm và máy chủ trong doanh nghiệp, và có thể gây ra mọi thách thức về hỗ trợ và bảo trì như bất kỳ phần mềm doanh nghiệp triển khai rộng rãi nào khác.
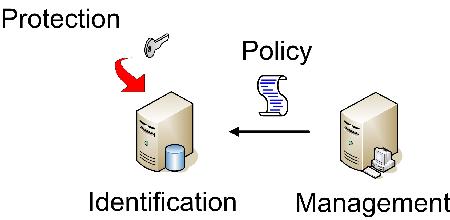
Hình 3. DLP dựa trên thiết bị đầu cuối.
DLP dựa trên thiết bị đầu cuối thường tìm và bảo vệ được nhiều dữ liệu nhạy cảm hơn giải pháp DLP dựa trên mạng. Ví dụ, giải pháp đầu cuối có thể giám sát việc chuyển dữ liệu sang thiết bị di động, còn giải pháp mạng thì không. Khả năng bổ sung này đi kèm cái giá cả về độ phức tạp lẫn chi phí, có lẽ vì vậy mà DLP đầu cuối chưa được triển khai rộng rãi như DLP mạng.
Các nhà cung cấp DLP thường bổ sung loại công nghệ thứ ba mà họ gọi là công nghệ “khám phá” (discovery). Công nghệ DLP discovery rất giống công nghệ đầu cuối, nhưng không chỉ tìm dữ liệu nhạy cảm khi có sự kiện cụ thể kích hoạt. Trong khi DLP đầu cuối có thể tìm dữ liệu nhạy cảm khi xảy ra một số sự kiện, như dữ liệu được chuyển sang thiết bị lưu trữ di động hoặc tệp được lưu, công nghệ discovery cố tìm mọi thông tin nhạy cảm trong dữ liệu đang lưu trữ. Để làm vậy, nó chủ động tìm kiếm trong dữ liệu lưu trữ và bảo vệ dữ liệu nhạy cảm tìm thấy.
Công nghệ DLP discovery bổ sung thêm một lớp bảo vệ ngoài lớp mà công nghệ đầu cuối cung cấp. Trong khi DLP đầu cuối và DLP mạng chỉ nhận diện và bảo vệ dữ liệu nhạy cảm khi xảy ra sự kiện nhất định, công nghệ discovery có thể bảo vệ toàn bộ dữ liệu nhạy cảm, ngay cả trước khi các sự kiện đó xảy ra. Ví dụ, nếu công nghệ discovery đã tìm và mã hóa toàn bộ số an sinh xã hội trong cả môi trường máy tính của doanh nghiệp, thông tin này vẫn được bảo vệ khi gửi qua mạng hoặc chuyển sang thiết bị di động.
Tóm tắt
Công nghệ DLP hứa hẹn giảm đáng kể lượng dữ liệu bị mất trong các vụ rò rỉ, và các nhà cung cấp DLP hàng đầu có giải pháp tìm và bảo vệ khá tốt những loại dữ liệu mà các luật và quy định phổ biến về bảo mật dữ liệu, quyền riêng tư đề cập.
Công nghệ DLP dựa trên mạng là cách ít tốn kém hơn để bảo vệ dữ liệu nhạy cảm, nhưng thường bảo vệ kém hơn DLP đầu cuối hoặc DLP discovery. Quyết định dùng công nghệ nào rất phức tạp và cần xét nhiều yếu tố, ít nhất gồm bản chất của các luật và quy định về cách bảo vệ dữ liệu nhạy cảm, và chiến lược quản trị rủi ro của doanh nghiệp đang cân nhắc triển khai DLP.
Bất kỳ công nghệ DLP nào bảo vệ dữ liệu nhạy cảm bằng mã hóa đều có thể gây ra những vấn đề không lường trước với quản lý khóa. Nếu đang cân nhắc điều này, hãy hỏi nhà cung cấp DLP về công nghệ quản lý khóa của họ và mức độ dễ dàng tích hợp vào mạng hiện có. Làm điều này ngay từ giai đoạn đầu đánh giá công nghệ DLP có thể giúp bạn tiết kiệm đáng kể thời gian và công sức khi triển khai và vận hành DLP trong doanh nghiệp.
Nguồn: Luther Martin & infosectoday.com